【IoT・データ連携】工場内の作業効率UP!タッチパネルをリモート操作する方法
fa-engineer
FAテック ラボ
この記事でわかること
前回の記事では、稼働率の改善が進まない理由を3つに整理しました。
▶ 設備の稼働率改善が進まない3つの理由|稼働監視・集中監視で変わること
今回は、その3つに答えるために作った、設備稼働監視システムの中身を紹介します。キーエンスPLCのデータを使って、稼働率・停止時間の内訳・異常の履歴を自動で集計し、ブラウザで見られるようにしたものです。
まずは3分の動画をご覧ください。
※ 動画は、設備の代わりに仮想PLC(PLCの動きをまねるプログラム)を使った試験運転です。
画面は3つあります。
| 画面 | 見られるもの |
|---|---|
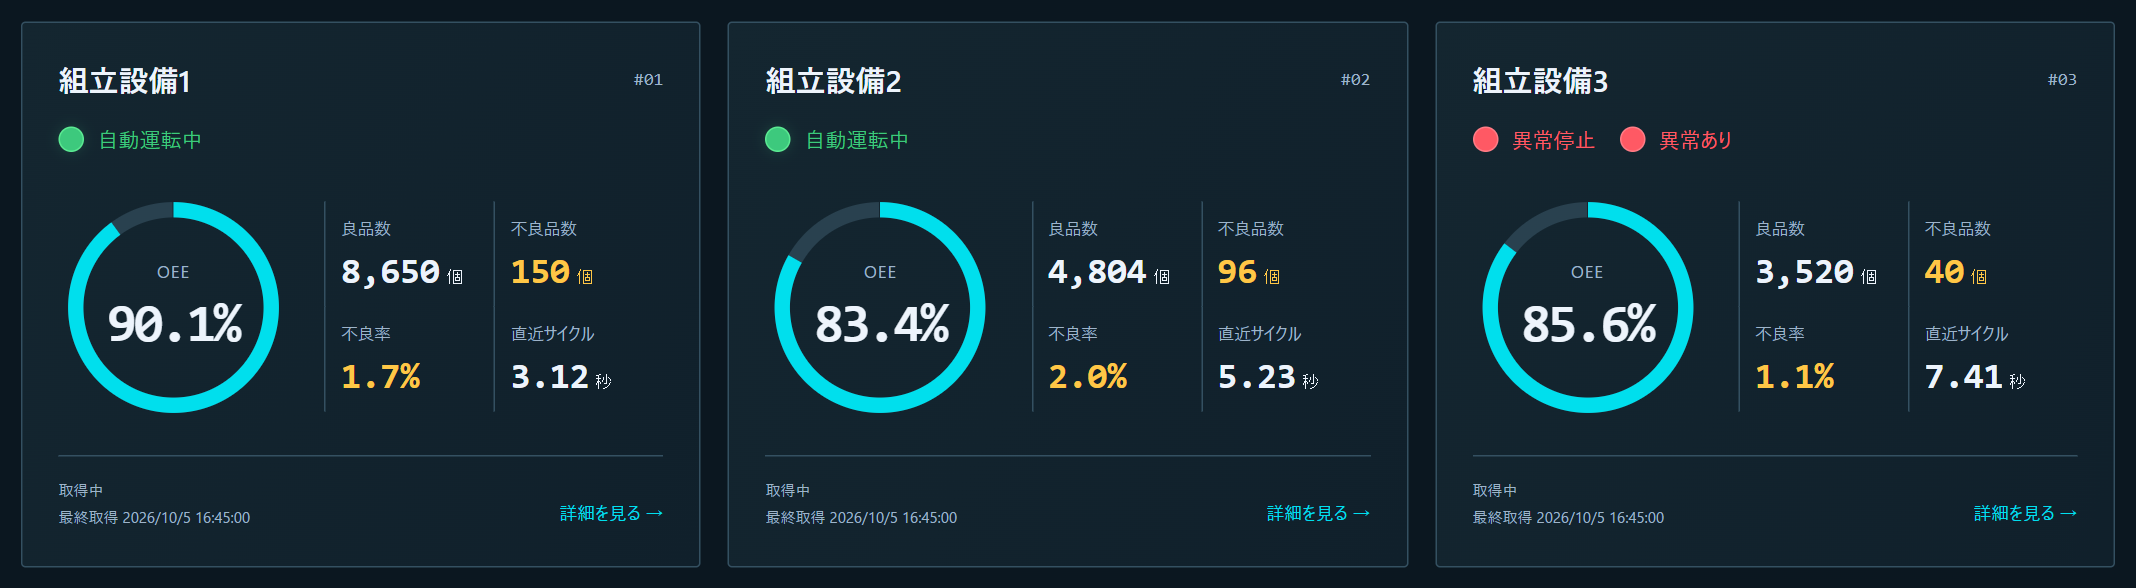
| 設備一覧 | 全設備の稼働率、良品数・不良品数、サイクルタイム、運転中か停止中か |
| 設備詳細 | 稼働率の内訳、停止時間の内訳、異常の履歴、異常ごとの集計、稼働状況のガントチャート |
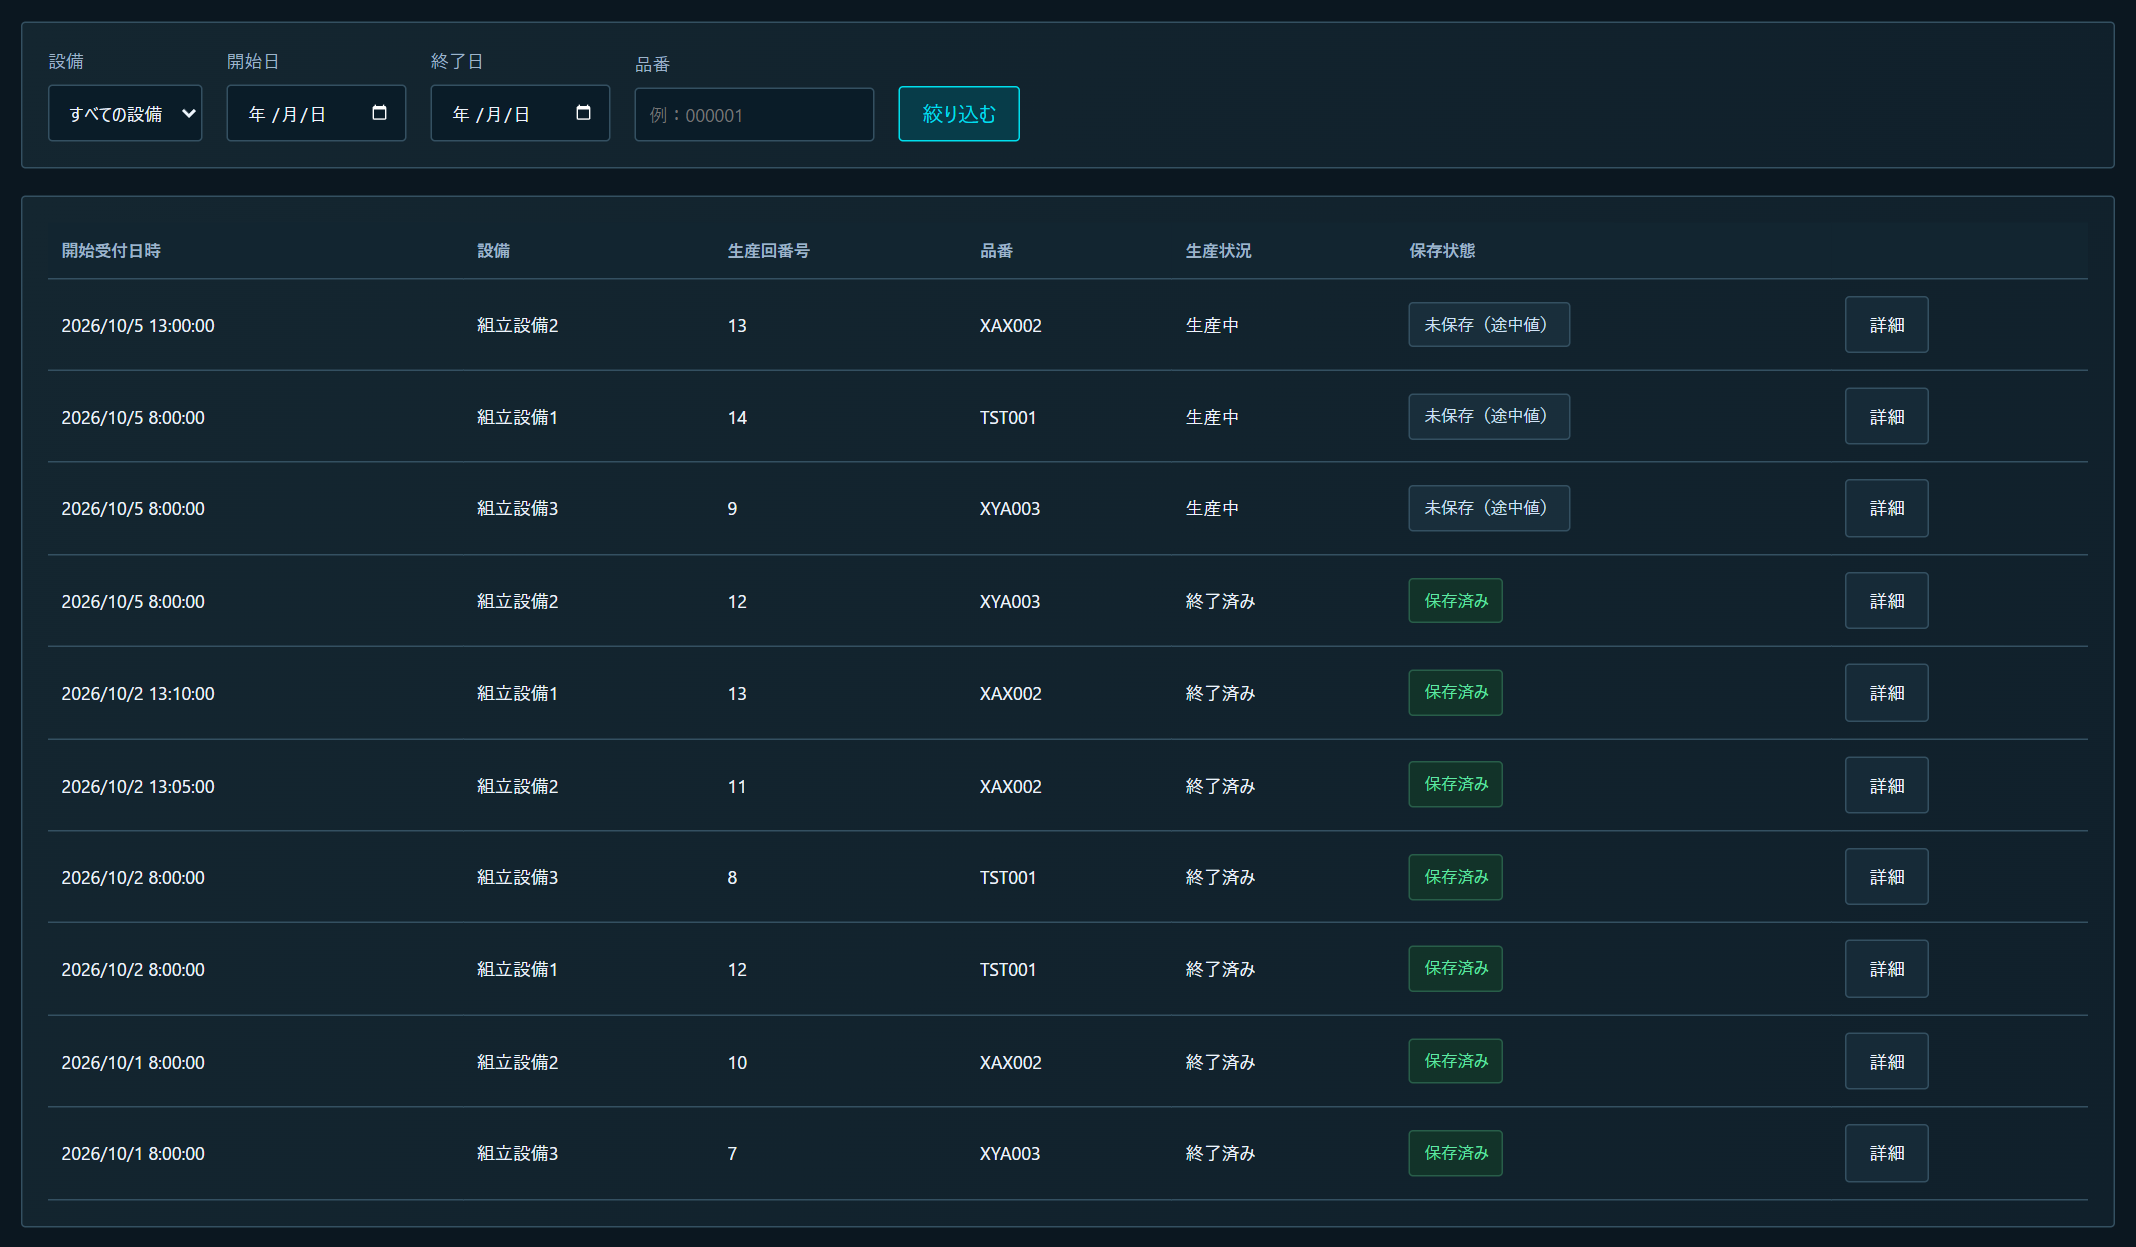
| 生産履歴 | 過去の生産の記録。設備・日付・品番で検索できる |
「異常の履歴なら、設備のタッチパネルにも残っている」と思われた方も多いはずです。そのとおりで、タッチパネルと稼働監視は役割が違います。
| タッチパネルの履歴 | 稼働監視システム | |
|---|---|---|
| 見る場所 | 設備の前まで行って、1台ずつ見る | 事務所のパソコンで、全設備をまとめて見る |
| 分かること | どの異常が、いつ出たか | それに加えて、止まっていた時間の合計と、稼働率への影響 |
| 向いている使い方 | その場での復旧、直近の異常の確認 | 原因の調査、改善の優先順位づけ、効果の確認 |
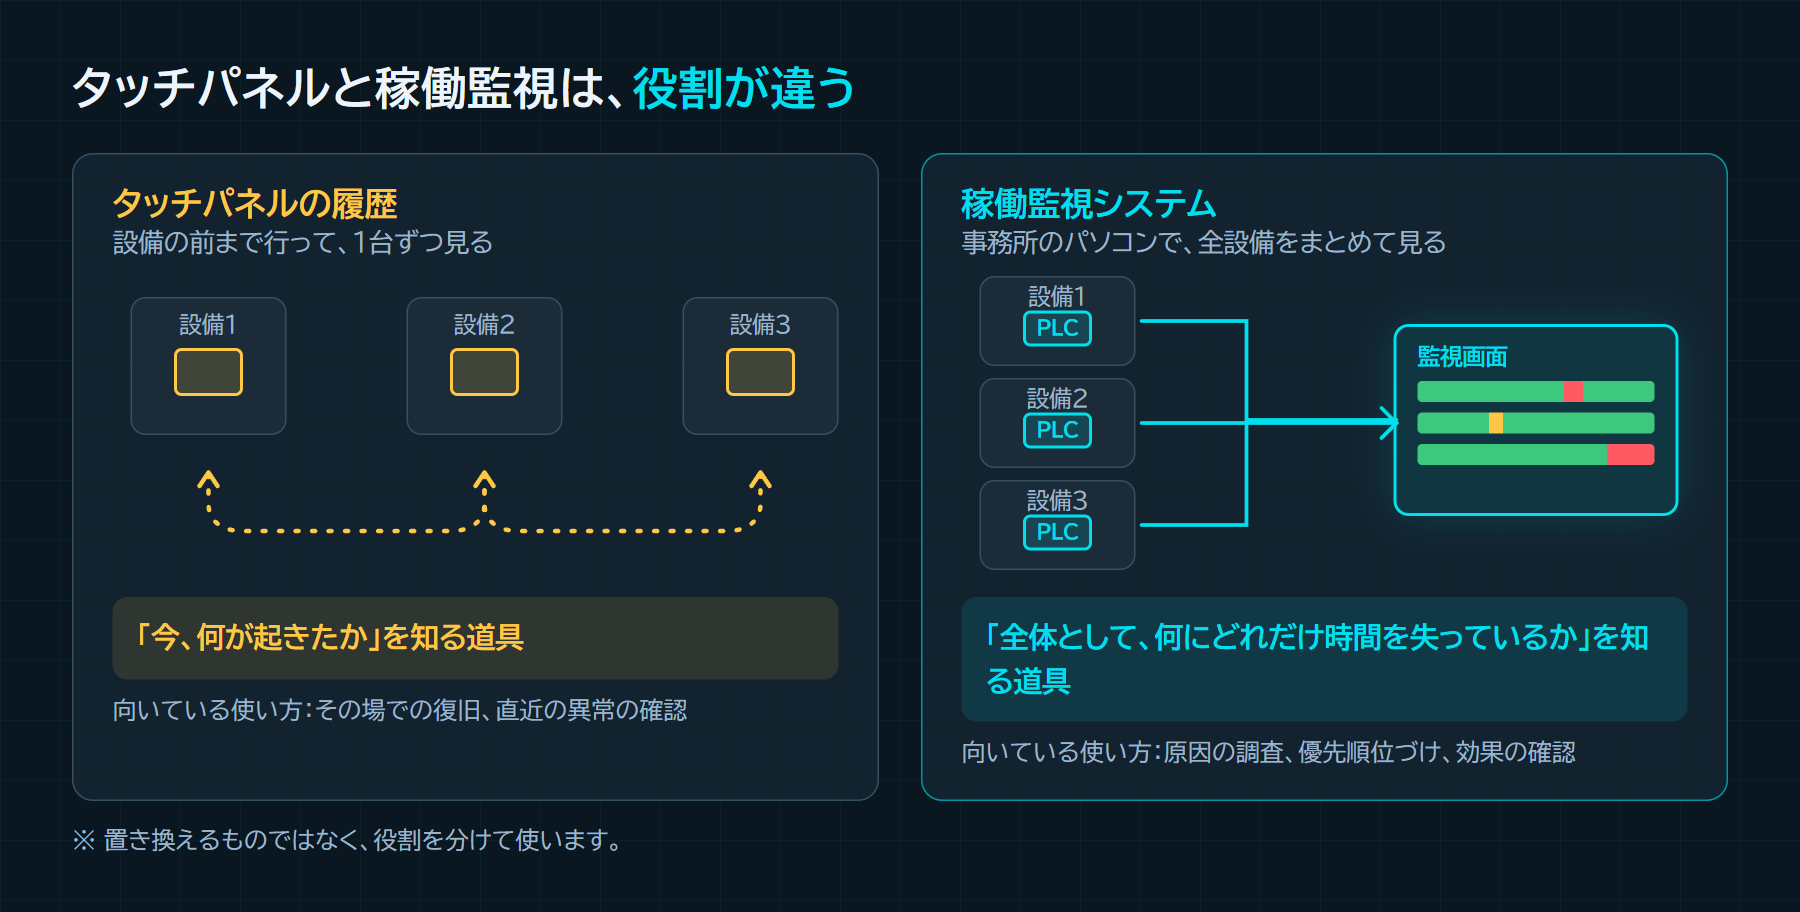
タッチパネルは、設備の前にいる人が「今、何が起きたか」を知るための道具です。稼働監視は、改善を進める人が「全体として、何にどれだけ時間を失っているか」を知るための道具です。置き換えるものではなく、役割を分けて使います。
原因の特定に時間がかかるのは、設備を回ってデータを集め、日報と突き合わせる作業が先にあるからでした。このシステムでは、その「事実集め」を画面を開くだけにします。
設備一覧の画面には、各設備の稼働率、良品数・不良品数、サイクルタイムが並びます。異常で止まった設備は、表示が切り替わるのですぐ分かります。
設備詳細の画面では、次の4つを並べて見られます。
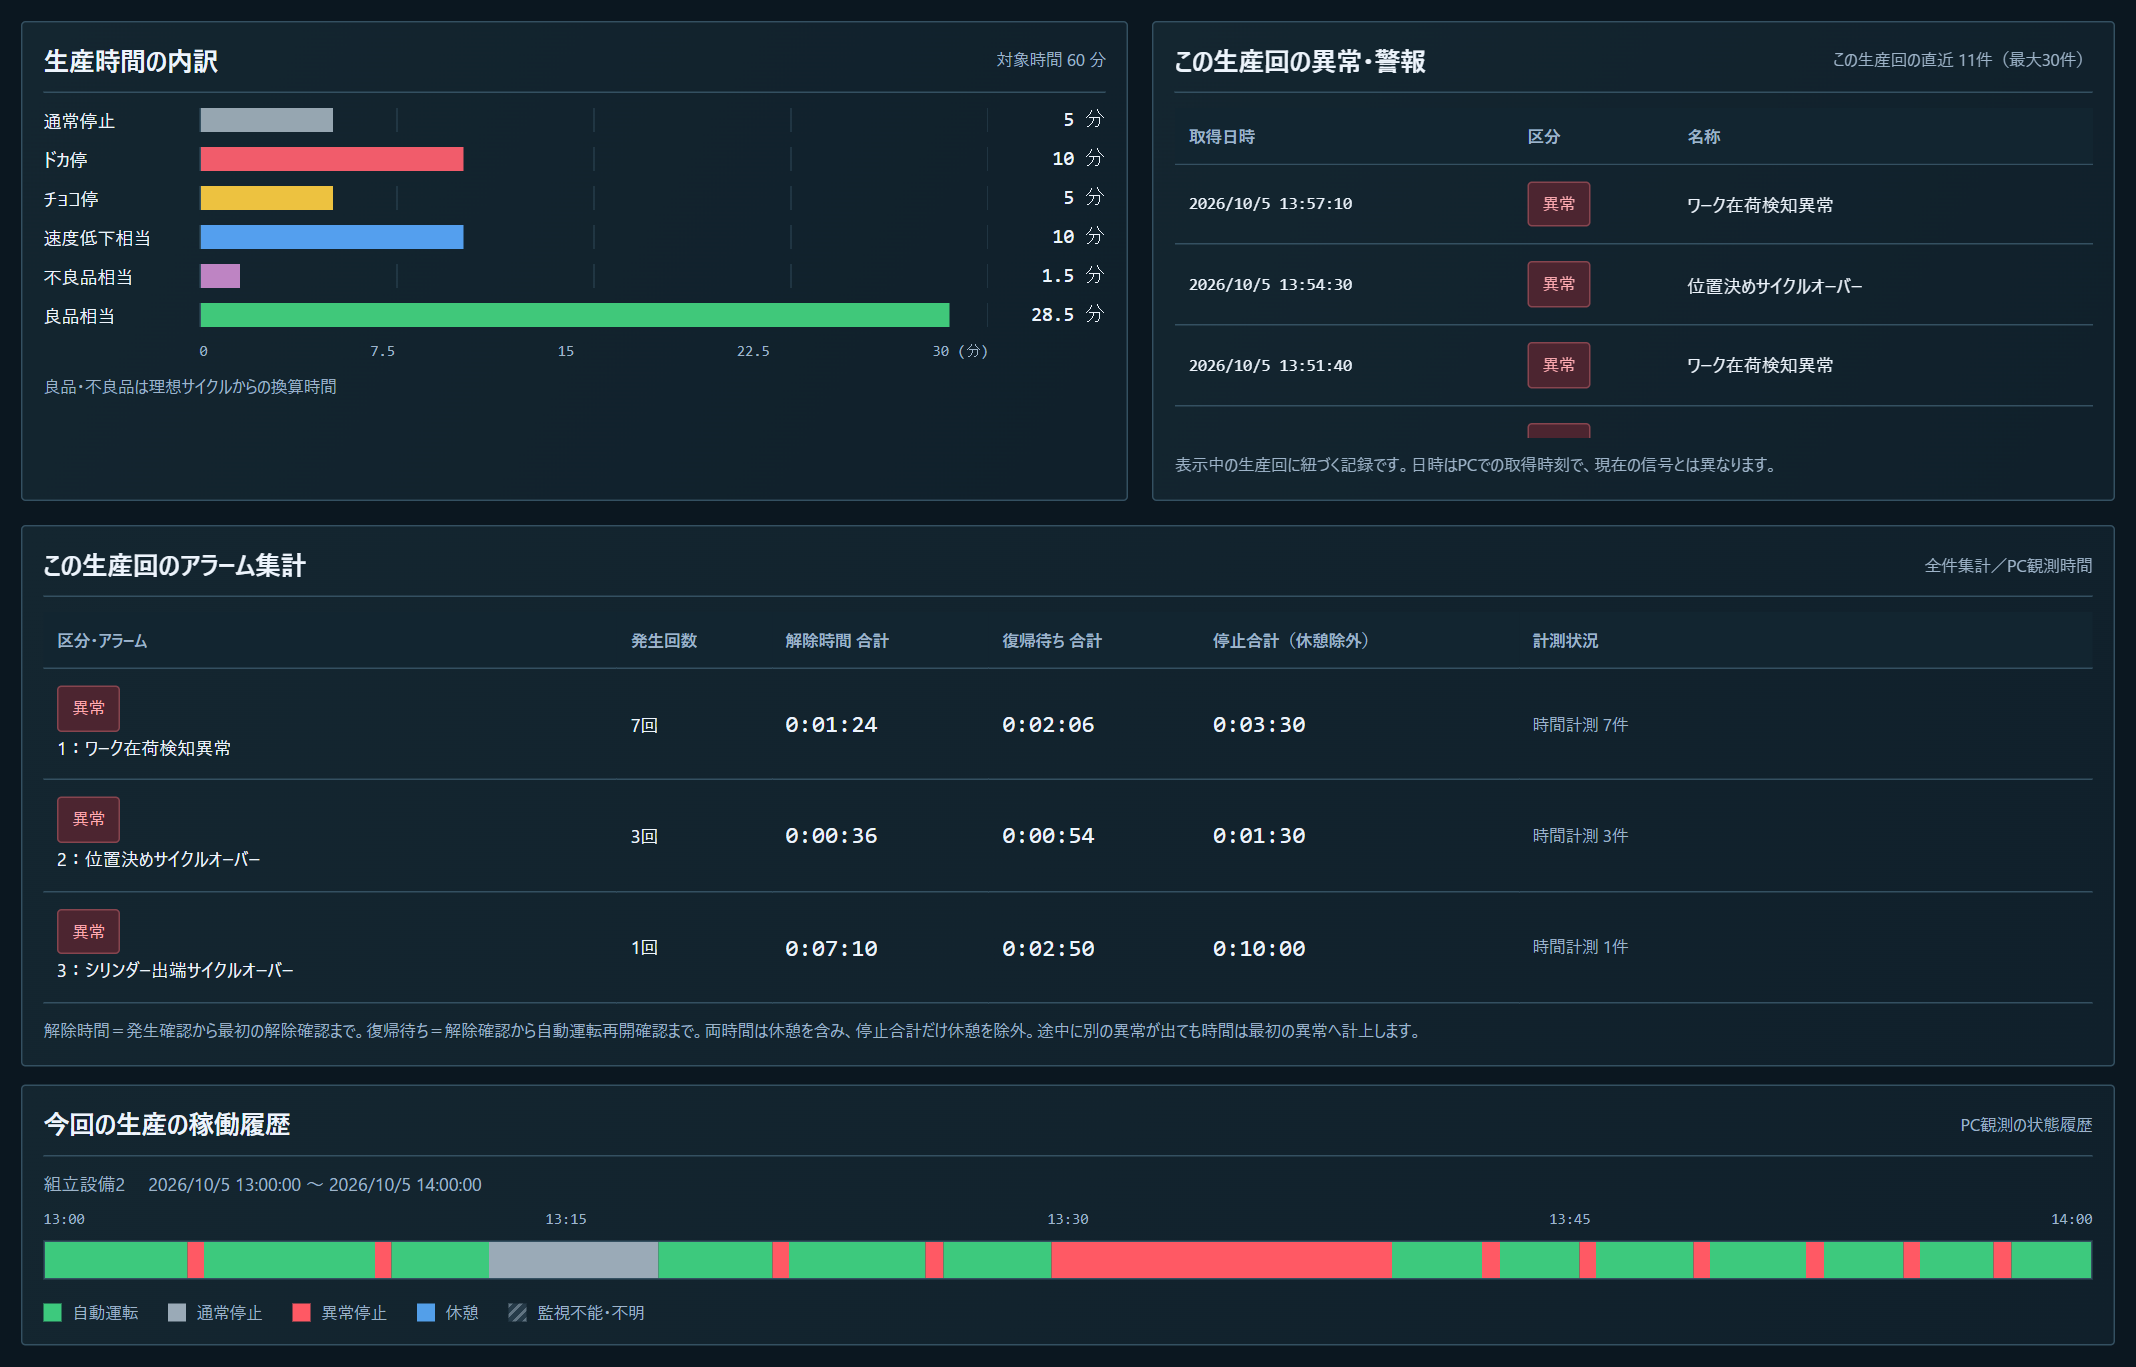
「午後に稼働率が落ちた」と分かったら、ガントチャートで止まっていた時間帯を見つけ、その時刻に出ていた異常を履歴で確認する。ここまでが、席を立たずにできます。
現場での観察がなくなるわけではありません。ただ、「いつ、どの異常のときに見ればよいか」の当たりを付けてから現場に行けます。
記録は「1回の生産」ごとに、品番と一緒に保存しています。「この品番のときだけ不良が多い」「先月と比べてどうか」といった調べものが、検索するだけで済みます。
現場から正確な情報が集まらないのは、人が書く記録に頼っているからでした。理由の書き方は人によって違い、後から記憶で書けば時刻もずれます。
このシステムでは、設備のPLCからデータを自動で取得します。人が記録する工程が、そもそもありません。
| 人が書く記録 | 自動で取得するデータ | |
|---|---|---|
| 停止の理由 | 書き方があいまいで、人によって違う | 異常ごとに決まった名前で、同じ基準で残る |
| 時刻と時間 | 後から記憶で書くので、ずれる | 発生したときに自動で記録され、止まっていた時間も数える |
| 記録の抜け | 忙しいと書かれないことがある | 生産している間は、常に記録され続ける |
| 作業者の負担 | 記録のたびに手が止まる | 入力は不要 |
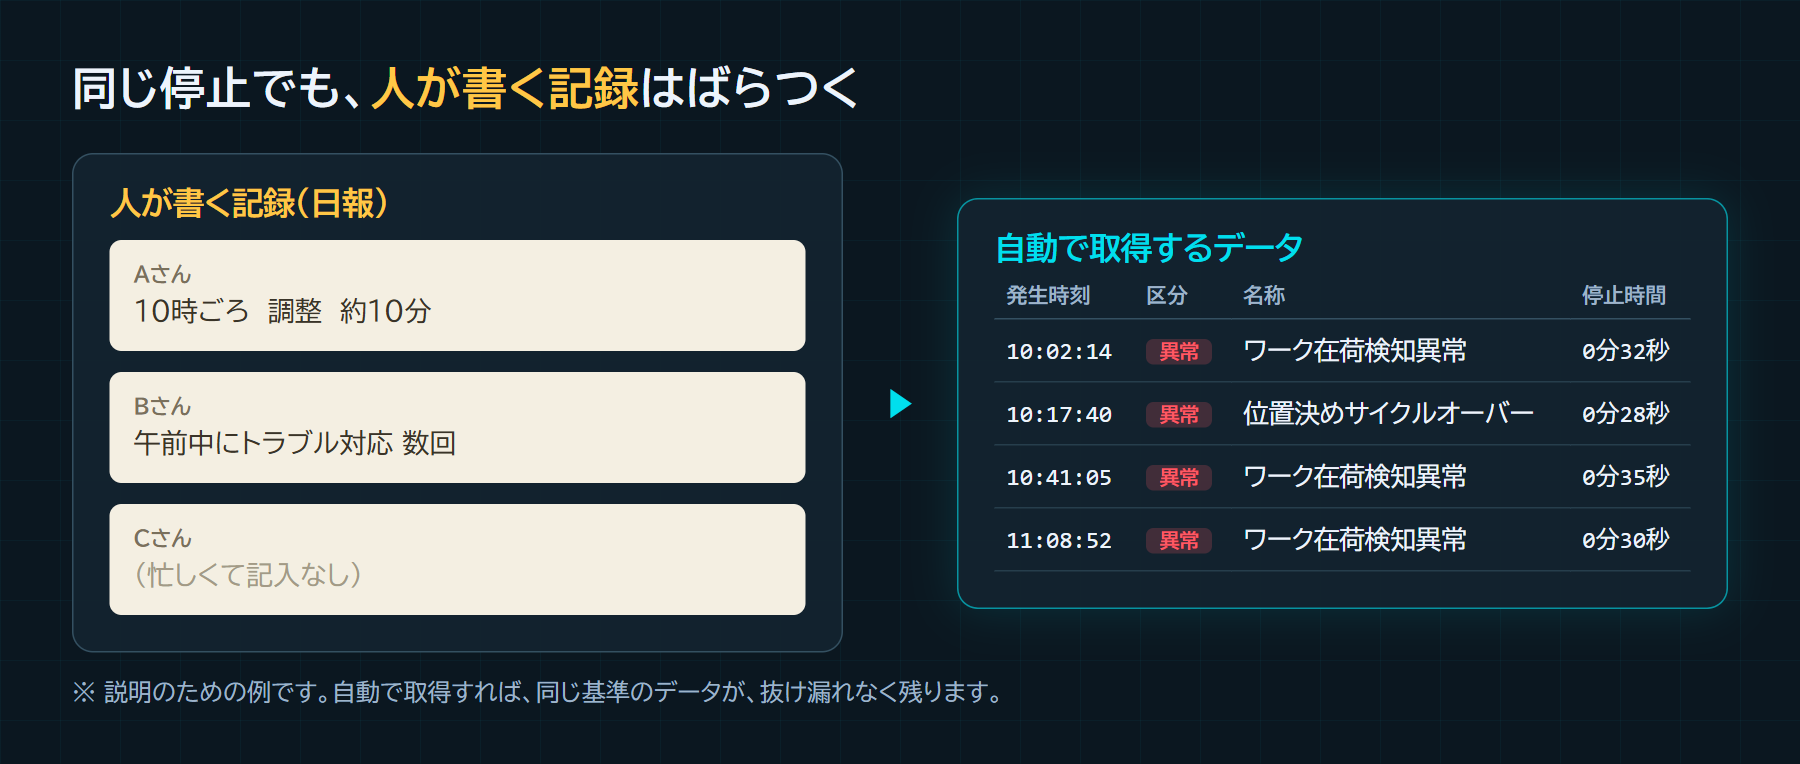
作業者は生産に集中でき、改善する側は「いつ、何回、どれだけ止まったか」を聞いて回る必要がなくなります。聞き取りは、「そのときワークはどんな状態だったか」のような、人にしか分からないことに絞れます。
改善項目は分かっているのに優先順位を決められないのは、それぞれのロスの大きさを、同じ物差しで比べられないからでした。このシステムでは、ロスをすべて時間にそろえて表示します。
異常の履歴だけでは、「回数が多い異常」と「1回が長い異常」のどちらが効いているのか、比べにくいままです。そこで、止まっていた時間を次のルールで自動で分け、合計します。
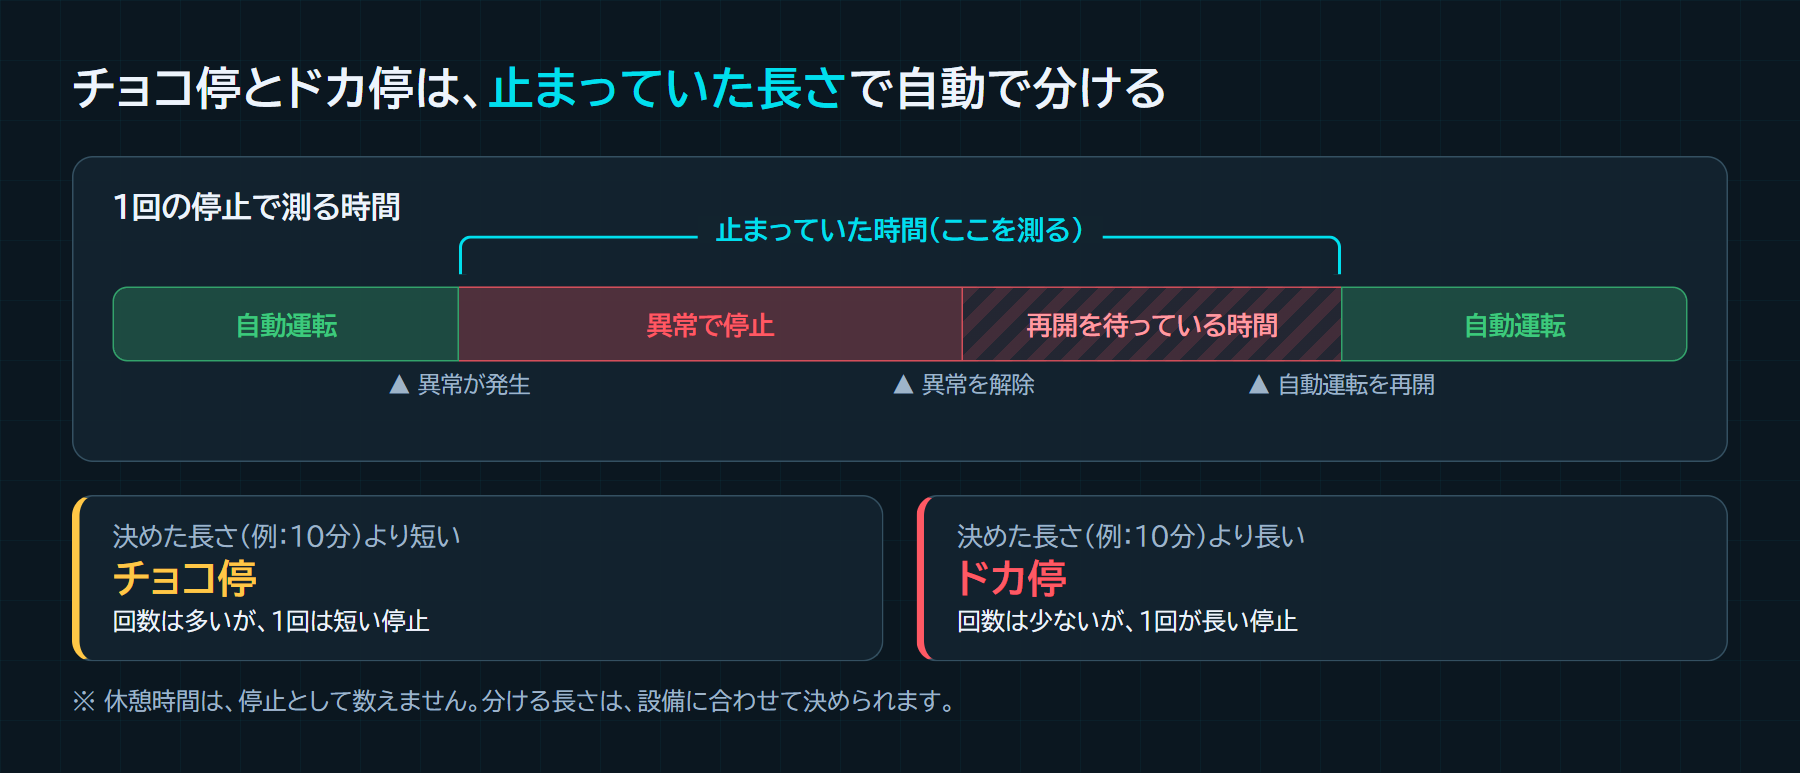
異常を解除したあと、再開を待っている時間も含めます。見たいのは「異常が出ていた時間」ではなく「生産が止まっていた時間」だからです。休憩時間は、停止として数えません。
稼働率は、OEE(設備総合効率)で表示します。次の3つの掛け算です。
数字を入れて計算してみます。ある生産で、次の実績だったとします。
| 項目 | 実績 |
|---|---|
| 自動運転の時間 | 40分 |
| 通常停止(段取りなど) | 5分 |
| チョコ停 | 5分 |
| ドカ停 | 10分 |
| 理想のサイクルタイム | 1個あたり10秒 |
| 良品数/不良品数 | 171個/9個 |
対象の時間は、全部を足した60分です。
| 指標 | 計算 | 結果 |
|---|---|---|
| 時間稼働率 | (60分 − 通常停止5分 − ドカ停10分)÷ 60分 | 75% |
| 性能稼働率 | (10秒 × 180個)÷ 45分 | 66.7% |
| 良品率 | 171個 ÷ 180個 | 95% |
| OEE | 75% × 66.7% × 95% | 47.5% |
同じ数字を、実際の画面に表示するとこうなります。
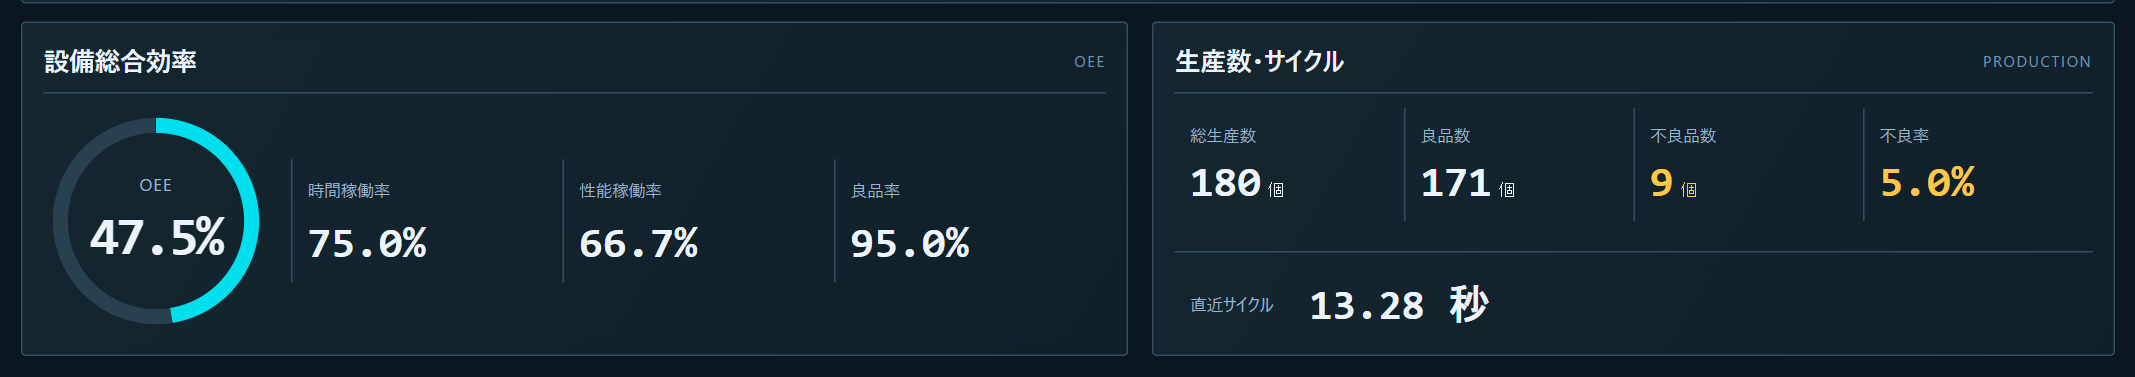
この例で一番低いのは、性能稼働率の66.7%です。
内訳を時間で見ると、長い停止(通常停止とドカ停)で失ったのが15分。一方、チョコ停の5分に加えて、理想より遅いサイクルで動いていた分が10分あり、こちらも合計15分です(180個を理想の10秒で作れば30分で済むところ、40分かかっているため)。
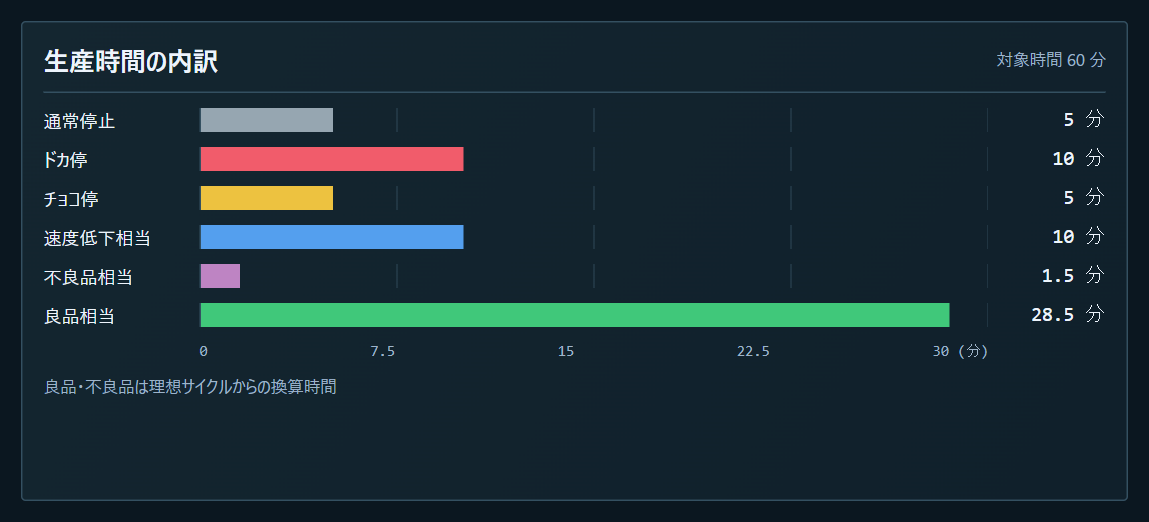
止まっていた時間だけを見ていると、この「動いてはいたが、遅かった10分」は見えません。3つに分けて表示すると、こうした隠れたロスにも気づけます。
なお、チョコ停は「時間稼働率」ではなく「性能稼働率」のほうに入れています。長い停止と同じ場所に入れると、チョコ停の影響が埋もれてしまうためです。両方から二重に引くこともしていません。
稼働率のどこで落ちているかが分かったら、次は「どの異常から手を付けるか」です。タッチパネルの履歴では分かりにくかった「それぞれの異常で、合計どれだけ止まっていたのか」も、自動で集計します。異常の名前ごとに、次の数字が並びます。
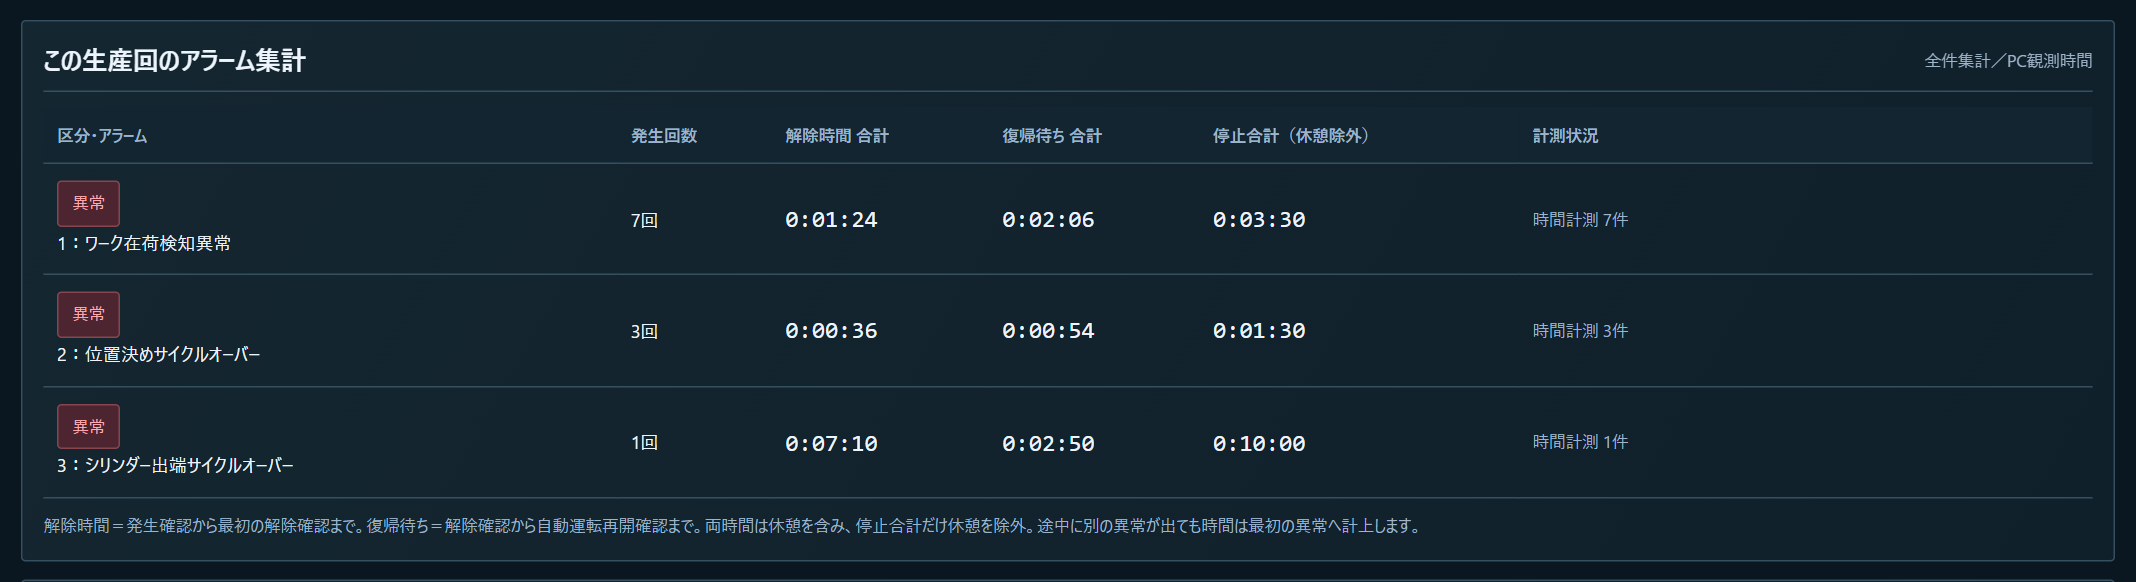
この例では、回数が一番多いのは「ワーク在荷検知異常」の7回です。ところが、止まっていた時間が一番長いのは、1回だけ出た「シリンダー出端サイクルオーバー」の10分です。回数だけを見ていると、手を付ける順番を見誤ります。
解除までの時間と、復帰待ちの時間を分けているので、「異常の処置に時間がかかっているのか」「処置のあと、再開までに時間がかかっているのか」も切り分けられます。
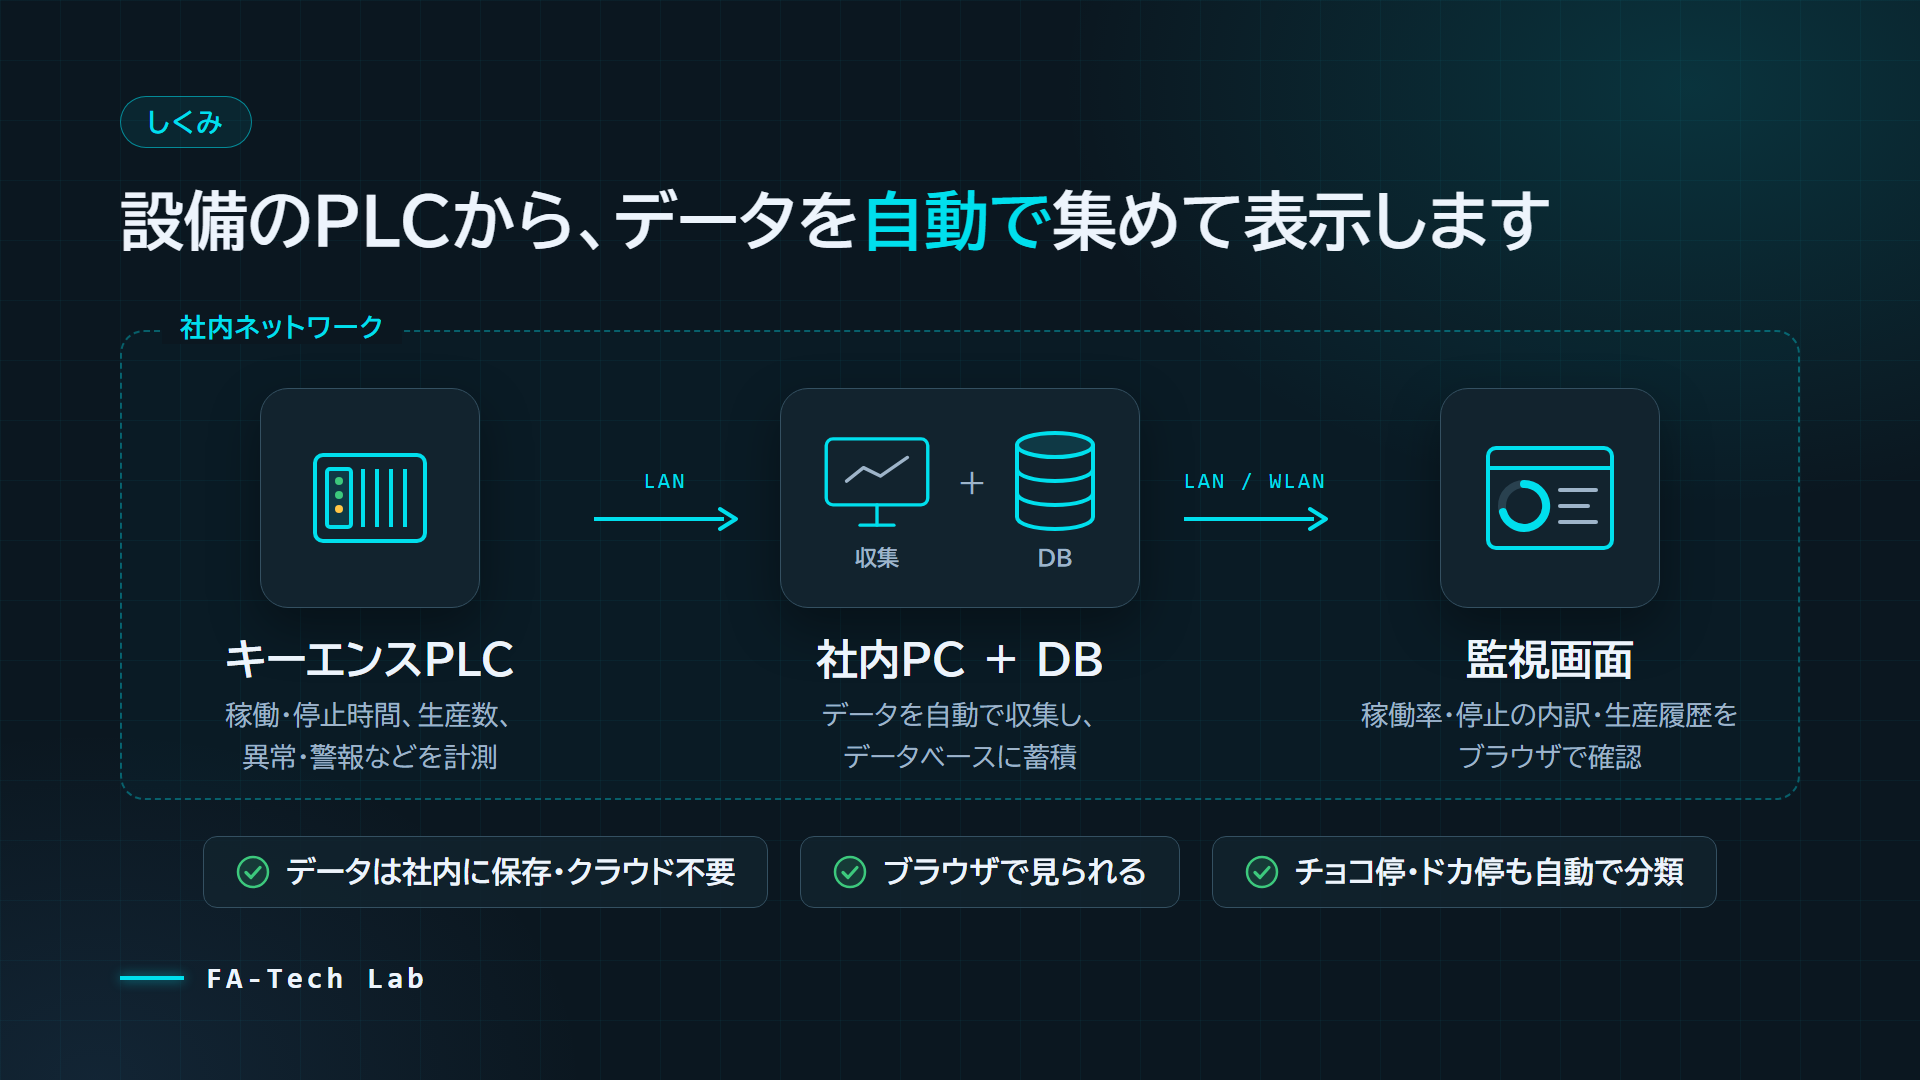
| 役割 | 使っているもの |
|---|---|
| 設備側 | キーエンスPLC(KVシリーズ)。時間と個数を数える |
| 通信 | 上位リンク通信(LANケーブルでつなぐ。PLCに標準で入っている機能) |
| 収集・計算 | Python。PLCから値を読み、稼働率を計算する |
| 保存 | PostgreSQL(データベース)。社内のPCに置く |
| 画面 | ブラウザ。社内のパソコンから見る |
データは社内のPCに保存します。クラウドは使いません。工場のデータを社外に出さずに済みますし、インターネットが切れても止まりません。
PLCからPythonで値を読む方法は、以前の記事で解説しています。
▶ PythonでKeyence PLCのデバイスを読み出す方法|上位リンク通信による設備IoT化
| 確認すること | なぜ必要か |
|---|---|
| PLCがLANでつながるか | 上位リンク通信はLAN(Ethernet)で行うため |
| PLCのプログラムデータがあるか | 監視用の処理を追加するため。コメント(信号の説明)が入っていると作業が早い |
| 必要な信号がPLCの中にあるか | 運転中・停止・異常・良品/不良品の信号。なければセンサーの追加などが必要 |
| 設備を止められる時間があるか | プログラムの書き込みと試運転のため |
| 異常の名前が整理されているか | 履歴に、誰が見ても分かる名前で残すため |
タッチパネルに履歴があるのに、別のシステムが必要ですか?
その場での復旧には、タッチパネルで十分です。稼働監視が役に立つのは、複数の設備をまとめて見たいとき、止まっていた時間の合計を知りたいとき、改善の前後を比べたいときです。
止まった原因まで、自動で分かりますか?
分かるのは「どの異常で、いつ、どれだけ止まったか」までです。なぜその異常が出るのかは、現場で確かめる必要があります。調べる範囲を早く絞り込むための仕組みです。
クラウドは必要ですか?
必要ありません。社内のPCにデータを保存し、社内のネットワークで見る構成です。
キーエンス以外のPLCでもできますか?
この記事の構成は、キーエンスのKVシリーズが前提です。ほかのメーカーの場合は、通信の方法が変わるので個別のご相談になります。
ラダープログラムは、自分で作る必要がありますか?
必要ありません。稼働時間や停止時間を数える処理など、監視に必要なPLC側のプログラムは、こちらで作成して組み込みます。現地での導入と動作確認まで対応します。
今のPLCプログラムを変える必要がありますか?
時間や個数を数える処理を追加します。追加するのは監視用の処理だけで、設備の動きや安全に関わる部分は変更しません。
何台から始められますか?
1台から始められます。まず困っている設備で試し、効果を見てから台数を増やすのがおすすめです。
| 悩み | このシステムでの答え |
|---|---|
| 原因の特定に時間がかかる | 全設備の稼働率・停止時間・異常の履歴・ガントチャートが、1か所に自動で集まる |
| 現場から正確な情報が集まらない | PLCから自動で取得するので、人による差も記録の抜けもなく、正確なデータが残る |
| 優先順位を決められない | 稼働率を3つに分けてどこで落ちているかを示し、チョコ停・ドカ停と異常ごとの停止時間を合計で出す |
タッチパネルが「今、何が起きたか」を見る道具なら、稼働監視は「全体として、何にどれだけ時間を失っているか」を見る道具です。
「うちの設備でもできる?」という段階のご相談で構いません
キーエンスPLCのデータを使った稼働監視システムの導入に対応しています。PLC側のプログラムの追加から、データ収集、監視画面、現地での導入まで一貫して対応します。設備1台から始められます。